Я полностью делегировал написание кода команде ИИ-агентов, не читаю написанный ими код и не провожу ревью кода: моя роль сводится к функциям Владельца продукта (Product Owner), формулированию требований и принятию ключевых продуктовых развилок. Есть понимание техники, но мной было решено, что продукт должна писать команда ИИ-агентов. Но без выстроенного процесса это не будет работать.
Важное вступление
Скептикам будет тяжело воспринять то, о чем я расскажу в этой статье. Многие до сих пор считают, что ИИ-агенты не способны писать код на уровне разработчиков. Почему сложилось такое мнение? Скорее всего, потому что люди брали любого ИИ-агента и давали ему в качестве технического задания промпт максимум из трех-четырех абзацев.
Представьте себе ситуацию: мы берем разработчика с рынка, сажаем его у себя в компании и даем ему техническое задание, состоящее из одного абзаца. Как вы думаете, какой код он напишет и как реализует продукт? Скорее всего, результат работы реального разработчика не будет соответствовать нашему чувству прекрасного и бизнес-идее.
Аналогичная ситуация происходит и с ИИ-агентами. Когда мы скармливаем им ТЗ в виде промпта из пары абзацев, на выходе получаем неудобоваримый продукт. Чтобы этого не происходило, нужно, как и в реальных компаниях, выстраивать процессы: создавать правила, регламенты и порядок работы. Тогда ИИ-агенты будут опираться на них и понимать, в каком ключе действовать. А чтобы продукт получался качественным, ИИ-агентам необходимо передавать готовые, глубоко проработанные технические задания.
У меня за плечами долгие годы работы — несколько десятков лет в IT. За это время я управлял командами тестировщиков, разработчиков, аналитиков, инженеров и тимлидов.
На заре карьеры у меня было мышление линейного исполнителя: что вижу, то и делаю, без понимания общей картины. Я не мыслил категориями бизнес-процессов компании. Со временем, нарабатывая опыт, я перестроился на процессный подход. Приходя в новую компанию, я сразу изучал действующие регламенты, находил узкие места, оптимизировал неэффективные цепочки, а там, где регламентов не было вовсе, выстраивал их с нуля. Когда работаешь руководителем, ты смотришь на систему сверху: видишь весь цикл разработки и поставки продукта, сразу замечаешь сбои и оперативно корректируешь процесс.
Многие же из тех, кто пытается создавать продукты силами ИИ-агентов, не поднимаются на этот уровень, чтобы охватить взглядом всю картину. Не мысля процессно, они пытаются буквально выбить результат директивами: «Сделай мне хороший продукт! Ты сделал плохо, это не то, чего я хотел». Но ИИ-агент — не телепат. Такой подход не имеет ничего общего с системной инженерией процессов, и он предсказуемо не работает — в чем многие уже успели убедиться.
С чего всё начиналось?
Длительное время я вынашивал идею создания собственного продукта. Однако для реализации качественного решения нужна команда единомышленников и профессионалов. Найти единомышленников трудно: мало кто мыслит теми же категориями, да и цели редко совпадают. Оставался один вариант — найм команды. Но привлечение сильных специалистов требует серьезных финансовых вложений, чего я на тот момент не мог себе позволить.
С наступлением эры искусственного интеллекта — периода, когда ИИ выросли до способности писать код на уровне крепких разработчиков, — я понял: время пришло, пора действовать.
Для меня как для владельца продукта классический разработчик — это ресурс, необходимый для написания кода. Точно так же и ИИ-агент — ресурс, решающий ту же задачу. А раз ресурс есть, моя задача как руководителя — выстроить процессы и запустить конвейер по производству цифрового продукта.
Сказано — сделано. Я начал проектировать систему, которая сегодня позволяет мне вести полноценную разработку силами ИИ-агентов. Этот подход не имеет ничего общего с модным «вайб-кодингом». Это строгий производственный цикл, включающий в себя:
- подготовку спецификации — подробного описания бизнес-требований;
- формирование бизнес-функциональных требований (БФТ) на базе спецификации;
- декомпозицию БФТ на конкретные задачи;
- составление детального ТЗ под каждую задачу;
- непосредственную разработку;
- приемочное тестирование и сдачу функционала.
В итоге я выработал методологию разработки, объединяющую человека и команду ИИ-агентов. Рассмотрим её подробнее.
Методология P.A.C.A
P.A.C.A — инженерная методология разработки программного обеспечения в структурированной связке человека (владельца продукта) и мультиагентных систем искусственного интеллекта.
Методология решает фундаментальные проблемы ИИ-разработки: галлюцинации моделей, дрейф архитектурных решений, переполнение контекстного окна и потерю управляемости при росте кодовой базы.
Для успешного применения этой методологии владелец продукта должен обладать серьезным техническим бэкграундом — как минимум выше среднего уровня. Если владелец продукта не имеет технических компетенций, то ему необходима команда, в составе которой будет архитектор продукта (человек), или он должен довериться ИИ-архитектору.
Почему P.A.C.A? Это аббревиатура из:
Product => Architecture => Cycle => Acceptance

Cycle: Development (AI) -> Review (AI) -> Security (AI) -> Test (AI)

Product (Human PO) => Architecture (AI) => Cycle [Development (AI) -> Review (AI) -> Security (AI) -> Test (AI)] => Acceptance (Human)
На русском:
Владелец => Архитектура => Цикл => Приёмка

Цикл: Разработка (ИИ) -> Код-ревью (ИИ) -> Безопасность (ИИ) -> Тестирование (ИИ)

Владелец (человек) => Архитектор => Цикл [Разработка (ИИ) -> Код-ревью (ИИ) -> Безопасность (ИИ) -> Тестирование (ИИ)] => Приёмка (человек)
1. Базовые принципы методологии
- Строгое разделение ответственности:
- Владелец продукта: формулирует продуктовые требования (БФТ), валидирует бизнес-развилки, утверждает глобальный технологический стек и принимает готовый функционал.
- ИИ-архитектор: декомпозирует требования, выбирает системные паттерны, следит за целостностью кодовой базы, нарезает ТЗ и выступает арбитром в технических развилках.
- ИИ-конвейер (Цикл): автономно реализует задачи, проводит ревью, аудит безопасности и тестирование в изолированных итерационных циклах.
- Заморозка стека: системный фундамент, языки, фреймворки, базы данных и соглашения по оформлению кода согласовываются один раз на старте проекта. Агенты не имеют права самовольно модифицировать базовый стек.
- Окно планирования: запрещено генерировать детальные ТЗ на весь проект вперед. Реализация 10–15 задач неизбежно меняет интерфейсы, схемы данных и окружение. Каждая следующая порция нарезается строго с учетом реального состояния кодовой базы после закрытия предыдущего пула. При старте проекта, создаются общие заголовки задач на реализацию проекта.
- Двухуровневая эскалация блокеров:
- Технические тупики: разрешаются внутри цикла ИИ-архитектором (без выхода за пределы замороженного стека).
- Продуктовые противоречия: немедленно останавливают задачу и передаются человеку.
2. Ролевая модель
| Роль | Сущность | Зона ответственности |
|---|---|---|
| Product Owner (PO) | Человек | Стратегическое видение, бизнес-требования (БФТ), валидация архитектурного фундамента, решение продуктовых развилок, финальная приемка функционала. |
| Architect | ИИ | Проектирование системы, сбор БФТ с человека, декомпозиция на порции по 10–15 задач, формирование детального ТЗ, постоянный технический надзор, арбитраж архитектурных развилок. |
| Developer | ИИ | Написание чистого исполняемого кода строго в рамках выданного ТЗ и базового стека. |
| Reviewer | ИИ | Статический анализ, проверка стиля кода, соответствие контрактам API, чистота архитектурных слоев, регрессионный контроль. |
| Security | ИИ | Аудит безопасности (SAST и DAST): сканирование уязвимостей (OWASP), выявление утечек секретов/ключей, инъекций, проверка зависимостей и валидация входных данных. |
| QA / Test Agent | ИИ | Генерация unit-, integration- и E2E-тестов, проверка граничных сценариев, прогон набора тестов. |
3. Детальное описание фаз
3.1. Фаза 1: Инициализация
Проводится единоразово при создании проекта:
- Владелец продукта определяет цели системы и формирует требования.
3.2. Фаза 2: Проработка архитектуры
Проводится единоразово при создании проекта:
- Владелец продукта и ИИ-архитектор определяют масштабируемость и ключевые ограничения системы.
- ИИ-архитектор формирует фундамент:
- Технологический стек (языки, фреймворки, СУБД, брокеры сообщений).
- Структуру репозитория и базовые архитектурные шаблоны (Clean Architecture, DDD, модульный монолит и т.д.).
- Правила форматирования, линтеры, строгую типизацию.
- Владелец продукта валидирует документ архитектурных решений. С этого момента технологический стек заморожен.
Фаза 3: Сбор БФТ и первичное планирование нового функционала (фич)
При старте реализации нового функционального блока (фичи):
- Человек передает требования ИИ-архитектору.
- ИИ-архитектор проводит сессию интервью: выявляет скрытые зависимости, уточняет крайние случаи, формулирует критерии приемки. Формируются бизнес-функциональные требования (БФТ) ИИ-архитектором с привязкой к технологическому стеку и т.д.
- Формируется общий высокоуровневый бэклог требований по фиче.
Фаза 4: Архитектурная проработка задач (10 задач)
- ИИ-архитектор инспектирует текущее фактическое состояние кодовой базы.
- Из общего бэклога извлекается объем работы строго на 10 атомарных задач (рекомендую не более 10 задач, не переполняется контекст ИИ-архитектора).
- Для каждой задачи архитектор генерирует спецификацию:
- Файлы, модули и зависимости, подлежащие созданию или модификации.
- Контракты интерфейсов, типов данных и методов.
- Четкие условия готовности (Definition of Done).
Фаза 5: ИИ-конвейер (цикл)
Проработанные задачи обрабатываются последовательно через 4 защитных контура:
- Development: ИИ-разработчик пишет код строго по спецификации конкретной задачи. Пишет базовый набор unit-тестов.
- Code Review: ИИ-ревьюер валидирует код на соответствие правилам, ТЗ, контрактам, канонам, чистоте, читаемости и отсутствия побочных эффектов. При замечаниях код возвращается на шаг Development.
- Security Check: специализированный агент сканирует код на уязвимости (SQL-инъекции, XSS, небезопасные зависимости, хардкод секретов). Тут проводится SAST и DAST. При обнаружении рисков задача возвращается на доработку.
- Testing: создаются, дополняются и выполняются тесты. Задача считается выполненной только при успешном завершении всего набора тестов без падений.
Протоколы разрешения инцидентов внутри цикла:
- Архитектурный надзор: если в ходе реализации выявляется конфликт интерфейсов или технический тупик, вызывается ИИ-архитектор. Он вносит корректировки в спецификацию, не выходя за пределы согласованного стека.
- Продуктовая эскалация: если в ходе реализации обнаруживается нестыковка в бизнес-логике или неопределенность поведения для пользователя, конвейер ставится на паузу. Вопрос адресуется владельцу продукта. Полученное решение вносится в ТЗ, после чего цикл возобновляется.
Фаза 6: Пользовательская приемка задач
После реализации всех проработанных задач (10 штук):
- Владелец продукта проводит приёмочное тестирование готового функционала.
- Маршрутизация по результатам приемки:
- Найдены дефекты: формируются задачи на исправление, которые включаются первым приоритетом в следующий этап.
- Приемка пройдена, не все задачи проработаны и реализованы: возврат на Фазу 4 (ИИ-архитектор считывает новый срез кодовой базы и прорабатывает следующие 10 задач).
- Приемка пройдена, все требования фичи закрыты: фича передается в релиз.
4. О процессе простыми словами
4.1. Как работает процесс и взаимодействие агентов
Формирование фундамента и декомпозиция
С чего начинается процесс? Владелец продукта совместно с ИИ-архитектором прорабатывает технологический стек проекта. Если у владельца продукта нет глубоких технических компетенций, к процессу подключается человек — архитектор решения (он же архитектор продукта), который вместе с ИИ-архитектором подбирает оптимальный технологический базис под будущую систему. Выбранный стек жестко фиксируется в спецификации продукта.
Параллельно формируется понимание: что именно делает продукт, для чего он нужен и какие бизнес-ожидания к нему предъявляются. Владелец продукта декомпозирует систему на крупные функциональные блоки. Например:
- Авторизация и аутентификация.
- Профиль и заведение клиента.
- Оформление заказов и так далее.
Все эти блоки также заносятся в спецификацию, чтобы ИИ-архитектор видел вектор развития системы и заранее учитывал глобальные технические ограничения.
Далее начинается поблочная проработка. Допустим, мы берем блок авторизации (регистрация, сброс пароля, OAuth-провайдеры). Мы передаем этот блок архитектору с задачей: «Проработай реализацию функционала». Архитектор начинает задавать уточняющие вопросы. Владелец продукта отвечает, дополняет контекст и формулирует ограничения. На выходе архитектор формирует документ с бизнес-функциональными требованиями (БФТ) по конкретному блоку.
Следующий шаг — реестр задач. На основе БФТ архитектор готовит реестр: перечень с предельно лаконичными описаниями того, что именно нужно сделать. Задачи сразу разделяются по слоям архитектуры: бэкенд, фронтенд, база данных и сопутствующая инфраструктура.
По итогам БФТ архитектор может сгенерировать внушительный объем — например, порядка пятидесяти задач. Однако пускать их в работу целиком нельзя: если заставить модель прописать детальные технические задания сразу на 50 или 100 задач, произойдет переполнение контекста, упадет качество и начнутся галлюцинации. Поэтому мы нарезаем реестр на управляемые порции — ориентировочно по 10 задач на этап. Архитектор составляет исчерпывающее техническое задание именно на эту первую десятку, после чего пачка отправляется на конвейер реализации.
Этот процесс одинаково работает как на старте нового проекта с нуля, так и при развитии уже зрелой кодовой базы: описываем крупными мазками новый функциональный блок -> передаём архитектору -> генерируем БФТ -> формируем реестр задач -> берем порцию из 10 задач, пишем ТЗ -> отдаём в разработку.
Внутренний цикл разработки задачи
Когда пул из десяти задач проработан и на каждую составлено исчерпывающее ТЗ, запускается цикл непосредственной реализации. Внутри каждой задачи действует строгий конвейер специализированных ролей:
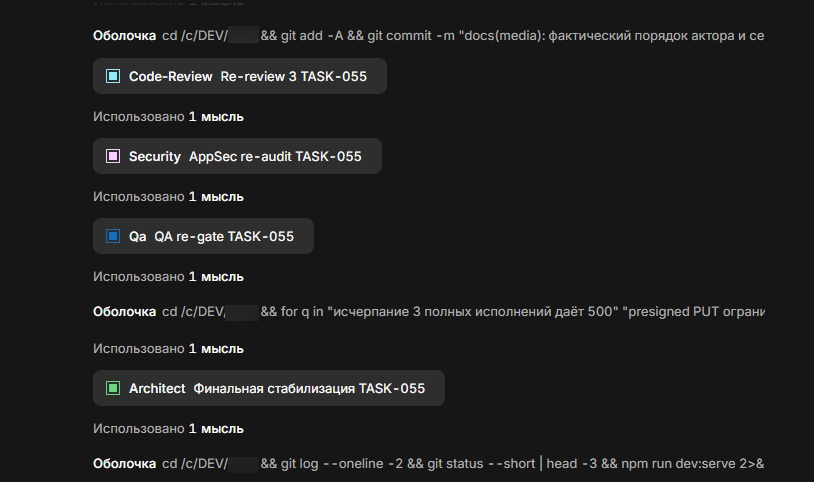
- Разработчик (Developer): основной агент, получающий задачу и пишущий код. Закончив реализацию, он не закрывает тикет, а автоматически вызывает субагента для проверки.
- Код-ревьюер (Code Reviewer): анализирует написанный код на соответствие стандартам, чистоту архитектуры и отсутствие технического долга. Если найдены замечания, задача возвращается разработчику на доработку.
- Инженер по безопасности (Security Engineer): когда код-ревью пройдено успешно, разработчик вызывает субагента безопасности, который проверяет код на уязвимости, утечки данных и инъекции. При наличии рисков задача снова уходит разработчику на исправление.
- Тестировщик (QA Engineer): при успешном прохождении безопасности разработчик передает эстафету QA-субагенту. Тот пишет необходимые модульные (unit) и сквозные (e2e) тесты, после чего прогоняет весь тестовый набор. После выполнения тестов QA возвращает отчёт разработчику.
Если на любом из этапов проверка не пройдена, задача возвращается разработчику в цикл: правка -> повторная валидация.
Кроме того, в процессе написания кода разработчик может упереться в неочевидную техническую развилку. В этом случае он сам вызывает субагента-архитектора. Тот предлагает техническое решение проблемы, разработчик берет его в работу и продолжает конвейер. Важно: вся разработка ведется строго в рамках утвержденного на старте технологического стека, поэтому архитектурные развилки (по базе данных, схемам взаимодействия, структурам кода) ИИ-архитектор решает автономно. Владелец продукта сюда не вовлекается — инженерные нюансы остаются в зоне ответственности технических агентов.
Оркестрация пула задач
Реализацию сформированного пула из 10 задач можно организовать по двум сценариям.
Сценарий 1: Ручная оркестрация владельцем продукта
Владелец продукта запускает разработчика на задачу №1. Разработчик отрабатывает внутренний цикл разработки задачи (разработка, ревью, безопасность, тесты) и выдает отчёт. Человек открывает новый контекст/чат, запускает следующего разработчика на задачу №2 и так далее. Минус этого подхода — человеку приходится постоянно находиться у монитора и вручную выдаать задачи — быть тимлидом.
Сценарий 2: Автономная оркестрация через агента-Тимлида (TeamLead)
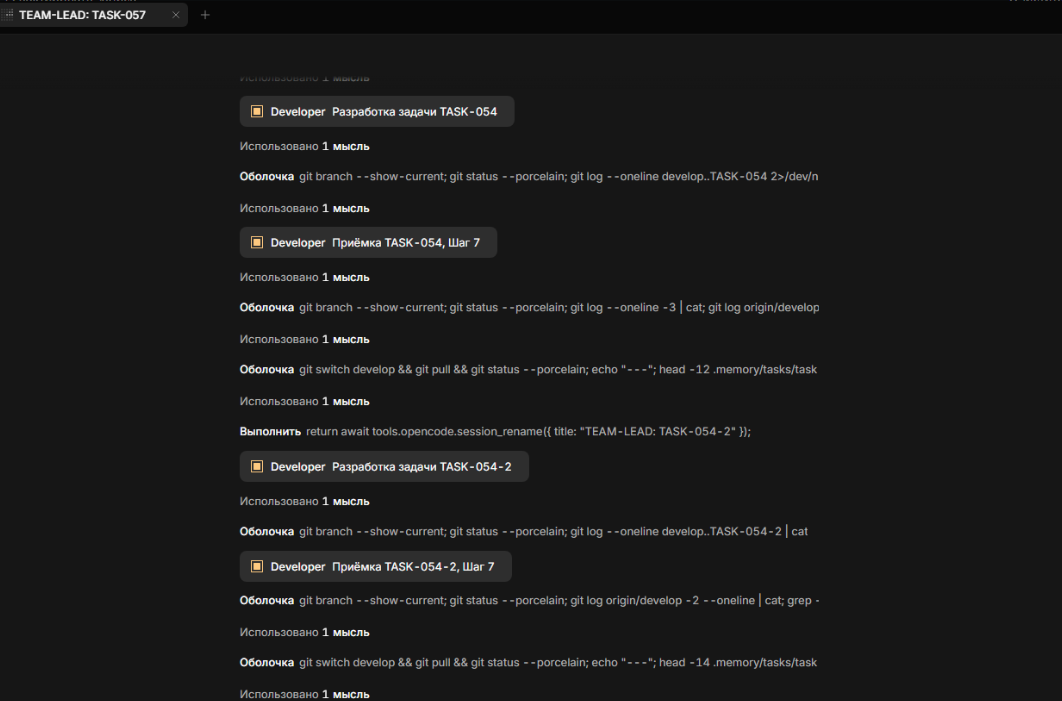
В систему вводится агент-Тимлид, которому на вход подается весь пул из 10 задач. Тимлид берет задачи по очереди и самостоятельно поднимает под каждую отдельного субагента-разработчика со всем его внутренним циклом разработки задачи (разработка, ревью, безопасность, тесты).
Тимлид принимает выполненную задачу у разработчика, оценивает соответствие критериям и при необходимости отправляет на доработку. Как только задача успешно принята, Тимлид автоматически запускает следующего разработчика на задачу №2 (в другой сессии). Конвейер работает без остановки, пока не выработает всю десятку задач, после чего Тимлид рапортует о завершении пула задач и ожидает формирования следующей пачки.
Отработка развилок: продуктовые против технических
Единственная ситуация, когда автономный конвейер обращается к человеку, — это продуктовая развилка.
Если в ходе реализации задачи Тимлид или разработчик обнаруживают бизнес-неопределенность (например, нужна ли на экране пагинация, и если да, то какой размер страницы выбрать: 10, 50 или 100 записей), агент ставит выполнение на паузу и прямо в чате обращается к владельцу продукта: «Обнаружена продуктовая развилка, требуется ваше решение». Владелец продукта отвечает на вопрос, снимает неопределенность, и агенты продолжают цикл.
Технические же развилки полностью решаются связкой «Разработчик — ИИ-Архитектор». Владелец продукта не тратит ресурс на споры о типах данных или названиях таблиц — он управляет исключительно бизнес-логикой и пользовательским опытом.
4.2. Правила и стандарты
Архитектура правил и стандартов
Описанный процесс может звучать идеалистично или даже фантастично. Если попытаться работать с ИИ-агентами «из коробки», без жестких рамок, реализовать подобную цепочку действительно невозможно. За всей этой слаженной схемой стоит строгий фундамент — система правил и стандартов.
У каждого агента и субагента есть собственные инструкции, зафиксированные в специализированных Markdown-файлах под конкретную роль. Универсального файла «обо всем сразу» нет — контекст четко изолирован. Помимо ролевых правил, в проекте действуют общие регламенты и стандарты взаимодействия.
Эта нормативная база живая: я непрерывно дополняю, шлифую и оптимизирую правила при малейших сбоях конвейера. Если разработчик начинает дергать архитектора по пустякам, я точечно переписываю границы ответственности разработчика. Если субагенты упускают контекст при передаче задачи — дорабатываю регламенты или формат отчетов.
Зоны ответственности и роли
- Правила для ИИ-архитектора: четко регламентировано, как именно прорабатывается задача, из каких обязательных секций состоит техническое задание, какова глубина детализации требований и как изолировать контекст, чтобы не ловить галлюцинации.
- Правила для ИИ-разработчика: это самый объемный свод правил. Разработчик в моей модели — полноценный владелец фичи (Feature Owner). Он не просто пишет код, а ведет задачу сквозь весь пайплайн: разрабатывает, запускает код-ревьюера, получает вердикт, устраняет замечания, затем передает эстафету безопасности, следом инициирует QA-тестирование и доводит задачу до финальной сдачи Тимлиду или владельцу продукта. В правилах детально зафиксированы триггеры вызовов: когда передавать код дальше, при каких условиях возвращаться на шаг ревью, когда сборка обязана падать и в каких случаях запускать полный регрессионный прогон.
- Правила для ИИ-код-ревьюера: описаны критерии оценки качества кода, лимиты сложности и специализированные скиллы, применяемые для статического анализа.
- Правила для ИИ-инженера по безопасности: выполняет аудит защищенности. В инструкциях зафиксированы вызовы специализированных скиллов, которые я разработал под безопасность веб-приложений: обязательное проведение SAST- и DAST-анализа, поиск утечек учетных данных и сканирование на уязвимости.
- Правила для ИИ-тестировщика: прописан перечень проверок (позитивные и негативные сценарии, тестирование под авторизованным и неавторизованным пользователем, валидация консоли браузера на ошибки…), а также стандарты написания юнит- и e2e-тестов.
- Правила для ИИ-тимлида: правила диспетчеризации пула задач — порядок инициализации разработчиков под каждую задачу, валидация входных/выходных артефактов, условия переключения на следующую задачу и триггеры остановки конвейера.
Благодаря правилам и стандартам агенты точно знают свои роли, протоколы взаимодействия и допустимые границы автономности. По сути мы имеем цифровую команду, которая может работать автономно, если нет продуктовых развилок.
Аналогичным образом я выстраивал процессы в реальных инженерных командах. Если нет четких правил и стандартов, сотрудники действуют на свое усмотрение, раз за разом отвлекая руководителя однотипными вопросами «а что делать здесь?». В мире ИИ-агентов это правило работает еще жестче: без формализованных регламентов конвейера не будет — начнется хаос.
4.3. Контекст и память
Закономерный вопрос: правила и стандарты определяют поведение, но откуда агенты черпают контекст самого проекта, архитектурные решения и статус текущей разработки?
Ответ прост — у агентов есть долгосрочная память. Она реализована через структурированную директорию memory прямо в репозитории проекта:
archive— каталог с архивом задач и прочих данных.modules— каталог с техническим описанием модулей системы.patterns— каталог с канонами и паттернами разработки.tasks— каталог с полными техническими заданиями задач.ARCHITECTURE.md— описание архитектуры проекта.DATABASE_SCHEMA.md— актуальные модели данных БД, связи, индексы и правила.HANDOFF.md— передача контекста следующей сессии (перезаписывается при каждой фиксации).PROGRESS.md— компактный дашборд текущего статуса проекта.README.md— правила работы с памятью, и описание структуры памяти.ROADMAP.md— глобальные этапы и вехи реализации проекта.TASKS.md— реестр открытых и активных задач текущего этапа.TECHNOLOGIES.md— технологический стек, текущие версии библиотек, правила окружения, описание стендов.
При старте сессии агент первым делом считывает файлы памяти — это жестко закреплено в его инструкциях. По завершении работы у ключевых ролей срабатывает строгое правило: не просто зафиксировать коммит в ветку, но и обновить целевые файлы в каталоге памяти. Благодаря этому каждый вновь запущенный агент сразу видит полную картину: какие задачи уже закрыты, что находится в активной разработке, а что стоит в ближайшем плане.
Чтобы не перегружать контекстное окно моделей по мере роста проекта и накопления выполненных тикетов, используются два механизма:
- Строгая фильтрация чтения: в правилах каждой роли зафиксировано, к каким именно файлам памяти она обращается.
- Архивация: архитектор регулярно проводит ревизию памяти, перенося завершенные или потерявшие актуальность срезы данных в подкаталог
memory/archive. В оперативной доступности остаются только текущий статус и живые артефакты.
Сейчас все данные памяти хранятся непосредственно в файловой системе репозитория в формате Markdown. Однако архитектура не привязана к файлам:
- реестр задач можно вынести в Jira, Redmine или YouTrack;
- архитектурные схемы и спецификации — в Confluence или Wiki;
- в директории
memoryпри этом остаются явные ссылки и манифесты доступа к этим внешним базам знаний.
Важный нюанс: при переносе контекста во внешние системы у агентов должны появиться соответствующие инструменты — специализированные скиллы (Skills) для чтения и записи данных через API Jira, Confluence или трекеров задач, чтобы они могли самостоятельно обновлять статусы и документацию.
На текущем этапе мои агенты ведут разработку последовательно: одна задача завершается, конвейер переходит к следующей. В такой парадигме структурированной файловой памяти внутри репозитория более чем достаточно.
Когда проект масштабируется до одновременной параллельной работы нескольких команд агентов над разными ветками, часть памяти неизбежно переедет во внешние трекеры и базы знаний. Но даже тогда директория memory сохранит роль центрального каталога и точки входа в проект — в ней будут храниться карты доступа: где ведутся задачи, где лежит архитектура, в какой системе описан технологический стек, где фиксируются инциденты, по каким канонам ведется кодовая база и т.д.
Итоги
Благодаря выстроенному процессу сейчас две команды агентов параллельно разрабатывают два проекта. Они пока находятся в активной разработке и развернуты на тестовом контуре, но текущий результат меня полностью устраивает. Когда первый продукт выйдет в продуктив, этот эксперимент по разработке полного цикла силами ИИ-агентов можно будет назвать состоявшимся.
При этом человек остается ключевым звеном системы — как минимум в роли постановщика задач, архитектора требований и конечного заказчика. Вступать в бесконечные споры о том, заменит ли ИИ разработчиков, не имеет смысла: время само все расставит по своим местам. Для себя я нашел рабочий инструмент, развиваю этот практический эксперимент и двигаюсь дальше.
Описанная мной методика — это готовый инженерный каркас, который можно адаптировать под свои задачи, от небольших сервисов до масштабных систем.
Внедрение агентов в разработку требует смещения фокуса: вместо ручного написания кода основной задачей становится проектирование процессов, изоляция контекста и контроль качества. Надеюсь, мой практический опыт поможет вам избежать типичных ошибок при переходе к агентной модели.
Навыки (skills)
Разработанные мной навыки для ИИ-агентов вы можете получить по ссылке https://github.com/zvmake/ai-skills
Скриншоты
Тимлид запускает задачи в разработку (в конце выдаст отчёт владельцу продукта: что сделано, как проверить):
Разработчик вызывает субагентов после реализации задачи: